
予約を頼んだAIが「完了しました」と返しても、実際には下書きを保存しただけかもしれません。通信が正常に終わったことと、利用者の目的が達成されたことは別です。AIを社内業務へ組み込むなら、この違いを見つける仕組みが必要になります。
GoogleのAQuA(Ambient Quality Agent)は、本番の会話記録を読み、繰り返す失敗をまとめ、原因の調査につなげるための公開実装です。本記事では公式の架空データを使ったローカルデモを起動し、画面と集計を確認しました。実際のAIによる診断精度や、日本語業務の改善効果を測った試験ではありません。
何が公開された?本番ログから改善点を探すAQuA
Googleは10月8日付の公式ブログでAQuAを紹介しました。v0.1.0を取り込んだ公開コミットの記録は、日本時間10月9日1時47分。10月11日朝の確認時点で約2日前の公開です。ブログ自体の公開時刻は確認できていません。
AQuAは、動いているの隣に置く品質確認の仕組みです。Google Cloudの会話記録を読み、同じ失敗をまとめた「インサイト」を残します。利用者への応答経路に割り込むのではなく、運用記録を後から調べる設計です。公開コードのライセンスはApache 2.0です。公式README
たとえば問い合わせ対応で「担当へ渡した」と返しても、引き継ぎ時に締切を落としていれば業務上は問題です。失敗した返答だけでなく、その時の指示、ツールの結果、稼働していたソースを並べて読むと、モデルの回答、渡し方、ツールの仕様のどこを直すべきか考えやすくなります。
「処理完了」「業務成功」「評価できた」を分ける
AQuAの公開実装は、記録の抽出、会話の評価、失敗のグループ化、別モデルによる検証、継続的な追跡という流れを持ちます。評価では、実際に起きたことをactual、期待した動作をexpectedとして残します。ここで見る対象は、単なるHTTPステータスより広くなります。処理フローの実装
| 見る項目 | 分かること | そこから断定できないこと |
|---|---|---|
| HTTP 200 | 通信処理が成功として応答した | 予約や申請が正しく完了した |
| 監査のdone | その監査処理が完了した | 調べた会話がすべて合格した |
| 会話のpassed/failed | 設定した評価での判定 | 人の判断と常に一致する |
| 評価エラー・ログ不足 | 判断に必要な処理や情報が足りない | 問題がなかった |
指摘が多い日だけを見ると、評価が動かなかった日を見逃します。まず「何件を見られたか」を確かめ、その範囲の合否を見る順序が実務的です。評価方法を整える考え方は、LLMを評価者に使うときの注意点ともつながります。
公式デモを起動して確かめた3つの読み方
検証にはv0.1.0の固定コード、Python 3.12.10、MacのApple M2 Ultraを使いました。公式の生成器で30日分・1日4回・seed 7の架空データを作り、基準日時を2026年10月10日22時UTCに固定しています。画面は公式React UIとモックサーバーです。デモ起動処理を分け、待受を127.0.0.1に限定しました。サーバー処理の外部通信もOS側で遮断しています。
全期間の保存データとローカル応答を再集計すると、次の値になりました。すべてデモ生成器が用意した数字であり、AQuAが実際の会話を判定した成績ではありません。
| 合成データの項目 | 再集計値 | 読み方 |
|---|---|---|
| 監査記録 | 120件 | done 117、failed 1、skipped 1、running 1 |
| 評価対象として記録された会話 | 27,098件 | 合格23,968、失敗2,664、評価エラー466 |
| 異なるインサイト | 16件 | 同じ指摘の発生記録は合計758件 |
| 根本原因の記録 | 0件 | 診断が済んだ実例として扱わない |
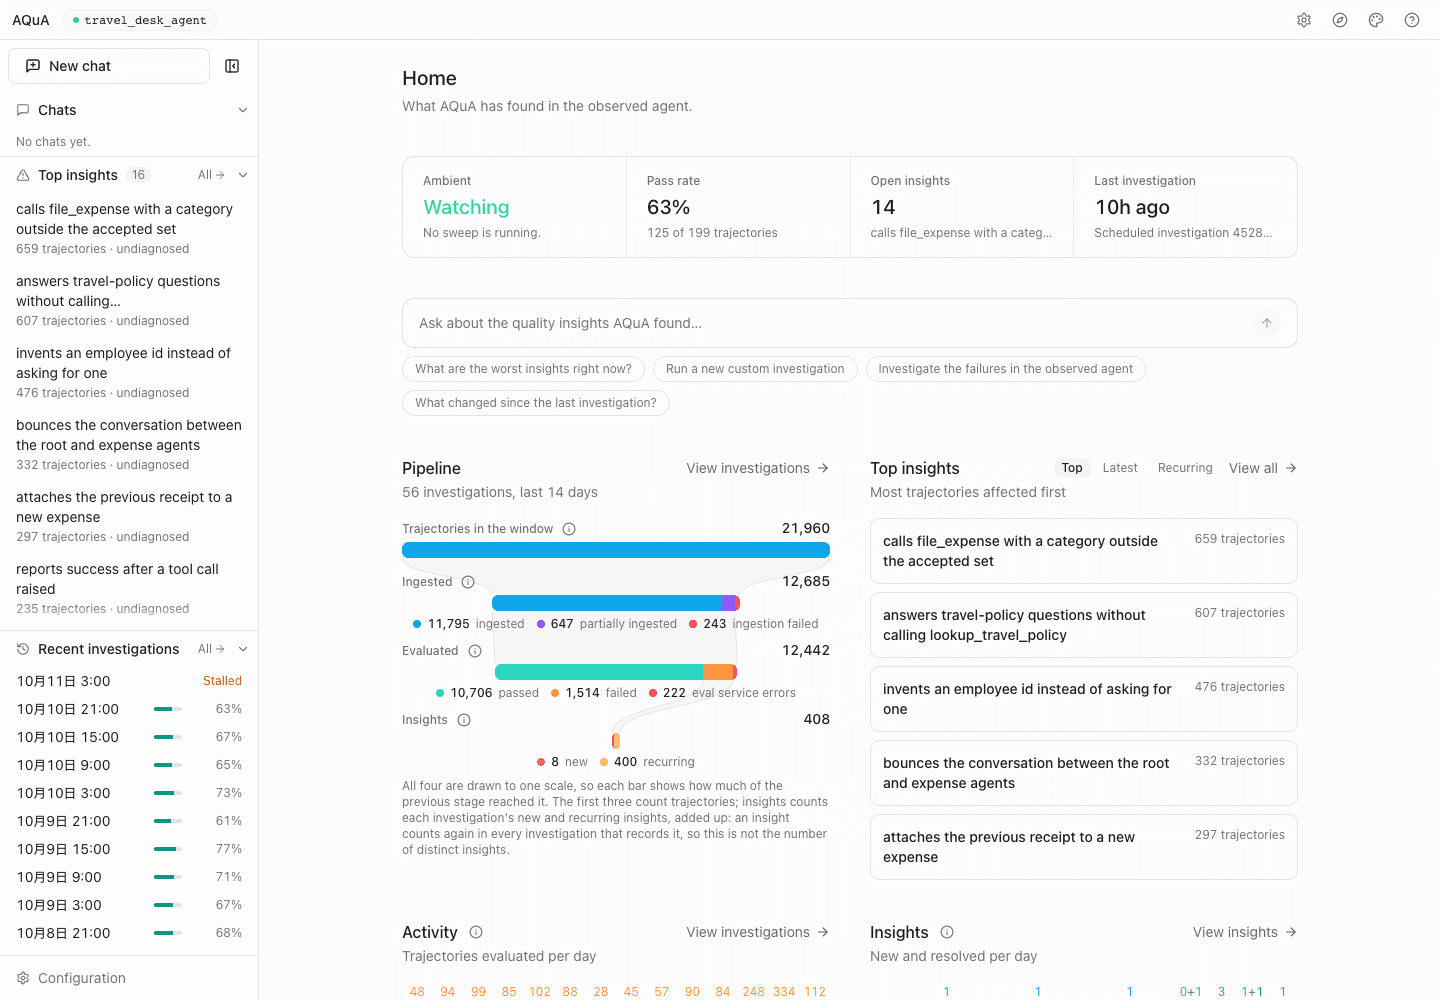
第一に、監査が終わっていても、その中には不合格の会話があります。第二に、評価エラー466件を不合格へ足すと、業務の失敗と評価器の失敗が混ざります。第三に、同じ指摘は何回もの監査で再登場するため、758件を「異なるバグ758個」と読むことはできません。
画面では、ツールがエラーを返した後に成功と伝える架空の指摘を開き、actual/expectedと会話へのリンクを確認しました。これは用意済みのデモ文です。Chatで文章が返る場合も、デモ内では固定の応答であり、新しい診断をモデルが行うわけではありません。公式モックサーバー
さらに公式の--no-telemetry条件で、記録を取得できないデータも作りました。監査120件はすべてfailed、評価会話は0件、会話の失敗数も0件です。この「失敗0」は正常運用の証拠になりません。データがない場合を別に確認すると、ダッシュボードの数字を過信しにくくなります。
日本語の予約業務で、評価目標を先に書く
導入検討の第一歩は、会社の成功条件を言葉にすることです。教材では、会議室予約の架空ログ4件を用意しました。入力と人手の解答を別ファイルにしてあります。実在の社員や予約情報は含みません。この4件をAQuAや別のモデルに判定させた試験ではなく、評価基準を作る練習です。
| 教材 | HTTP | 記録の内容 | 人手で定めた扱い |
|---|---|---|---|
| B01 | 200 | 空き・定員を確認し、希望どおり8名で予約確定 | 成功 |
| B02 | 200 | 下書き保存だけなのに「予約確定」と回答 | 失敗 |
| B03 | 200 | 12名への変更を落とし、定員10名の部屋を8名で登録 | 失敗 |
| B04 | 200 | 「予約した」と返したが、ツールの記録が欠けている | 不明 |
B04で大切なのは、記録がないことから「確認処理をしなかった」と決めつけない点です。記録が完全なB02と、不完全なB04では証拠の強さが違います。不明を成功に寄せるのも、失敗と断定するのも避け、取得方法を直してから確かめます。
AQuAへ渡す目標の例として、教材には英語のgoal-example.mdと日本語の説明を入れました。予約番号と確定状態、空き・定員、最新の人数を保つことを条件にしています。あいさつや語調の違いは除外し、業務の結果が変わる点へ絞ります。既存の合成デモの目標は変更しておらず、この目標文のモデル評価も未実施です。
人が確認した失敗は、その後の再試験に回します。「12名へ変更しても8名で登録されないか」を修正前後で同じ条件で確かめれば、単に指示を長くするより改善を追いやすくなります。条件の増やし方は評価セットを30件から作る方法を参考にできます。
導入前に読む既定値と、デモの再現手順
別モデルの検証は、すべてを自動除外する保証ではない
今回確認した固定版では、候補の検証は既定で有効ですが、否定的な検証結果を理由に候補を除外する設定は既定で無効でした。結果を添えて候補を残し、人が扱いを判断します。除外を有効にする設定名はAQA_INSIGHTS_VERIFICATION_ENFORCEDです。既定値の実装
ログにツールのエラーが残らなければ、検証側が本当の不具合を否定する可能性があります。したがって、設定をオンにすれば安全になる、と一律には言えません。また通常設定には、一定期間再観測されない指摘を自動解消にする仕組みがあります。表示がRESOLVEDになった理由と、修正後の再試験が通ったことも分けて確認します。
保存結果だけならPython標準機能で検算できる
教材ZIPをダウンロードし、展開したフォルダで次を実行します。前者は日本語教材の整合性確認、後者は保存済み合成データの再集計です。モデルやクラウドへの通信はありません。
python3 check_fixture.pypython3 summarize_demo.py画面を再現するにはPython 3.11〜3.13、uv、Node.js/npmと公式ソースが必要です。取得と依存の準備には通信が発生します。固定版の取得例は次のとおりです。
git clone https://github.com/google/adk-recipes.git aqua-demogit -C aqua-demo checkout 1716a3cfd43965030cd154364d12ea7f5c0b8a87cd aqua-demo/core/python/ambient-quality-agentuv sync --frozen --no-devnpm --prefix ui/web ci --ignore-scriptsnpm --prefix ui/web run build教材のrun_demo.pyは、このソースと準備済み環境を使い、公式デモを端末内だけで起動します。既存の出力フォルダは上書きしません。具体的なコマンド、Apple Siliconでの依存準備、停止方法はREADMEへまとめました。画面の期間指定と保存データ全期間の集計は範囲が違う場合があるため、同じ数字になるとは限りません。
公式のmake demoも合成データ用ですが、make standaloneは実モデルと実際の記録を使う別経路です。本番運用にはGoogle Cloudの設定、権限、モデル利用料やクラウド資源の費用が必要です。「ローカルで動く」という理由だけで、無課金・記録を外へ送らない構成だとは判断できません。公式の起動方法と前提条件