
請求書の画像から文字を起こせても、「どの数量と単価が対応するのか」「元のページのどこを読んだのか」は別に確かめる必要があります。は、文字に加えてページ内の位置や図表の情報も返すモデルです。日本時間2026年10月9日1時15分の公式発表を受け、最小の0.8B版を架空の日本語資料で試しました。
今回の2枚では、請求明細は両モードで一致し、棒グラフはgroundingを使うと月と件数の表になりました。一方、図の注記には1文字の読み違いが残りました。文字起こし・表への変換・位置の確認を分けて、成功した部分と残った誤りを見ていきます。
文字起こしとgroundingで何が違う?
通常モードは画像だけを渡し、ページの文章をMarkdownなどで取り出します。新しいgroundingモードでは、画像にgroundingという短い文字列だけを添えます。出力には、文章・表・グラフなどの種別と、その領域を示す座標が加わります。画像には短い説明、グラフにはデータ点のHTML表が付く設計です。公式モデルカードで2つのモードと出力形式が公開されています。
たとえば表の前にのような印が付きます。この例は説明用で、実測出力ではありません。4つの数は左上と右下の位置で、画像の幅と高さをそれぞれ0〜1000にした相対値です。1000×1200pxの画像なら、y=400は上から480pxに相当します。絶対ピクセル座標のつもりで重ねると位置がずれます。
位置が分かれば、請求額を読んだ根拠の箇所を人に見せる画面や、報告書のグラフを検索対象にする処理へつなげられます。ただし、座標があること自体は認識内容が正しい証拠ではありません。文字が合うか、表の行と列が合うか、指定された範囲が実物を囲むかを分けて確認します。
0.8Bを選び、架空の2ページを固定した
LightOnOCR-3には0.8B・1B・4Bがあります。1Bは前世代のLightOnOCR-2と同じ系統の構成、0.8Bと4BはQwen3.5の視覚と言語を扱う構成です。公式は4Bを多くの用途に推奨していますが、今回は小さな環境で検討する入口として0.8Bだけを選びました。4Bや旧版との優劣は比較していません。公式は多言語対応を説明していますが、日本語帳票全般の精度保証を示すものではありません。公式発表
試験前に画像と正解を固定し、正解ファイルはモデルへ渡していません。対象は次の2枚です。実在する取引先、請求、振込先は含めていません。
| 入力 | 人が先に決めた確認点 |
|---|---|
| 日本語の請求書 | 資料作成2×12,000円、会議準備3×8,000円。小計48,000円、税4,800円、合計52,800円。番号・日付・期限も照合 |
| 日本語の棒グラフ | 1月12件、2月18件、3月9件。月と値の対応、単位、表として取り出せるかを確認 |
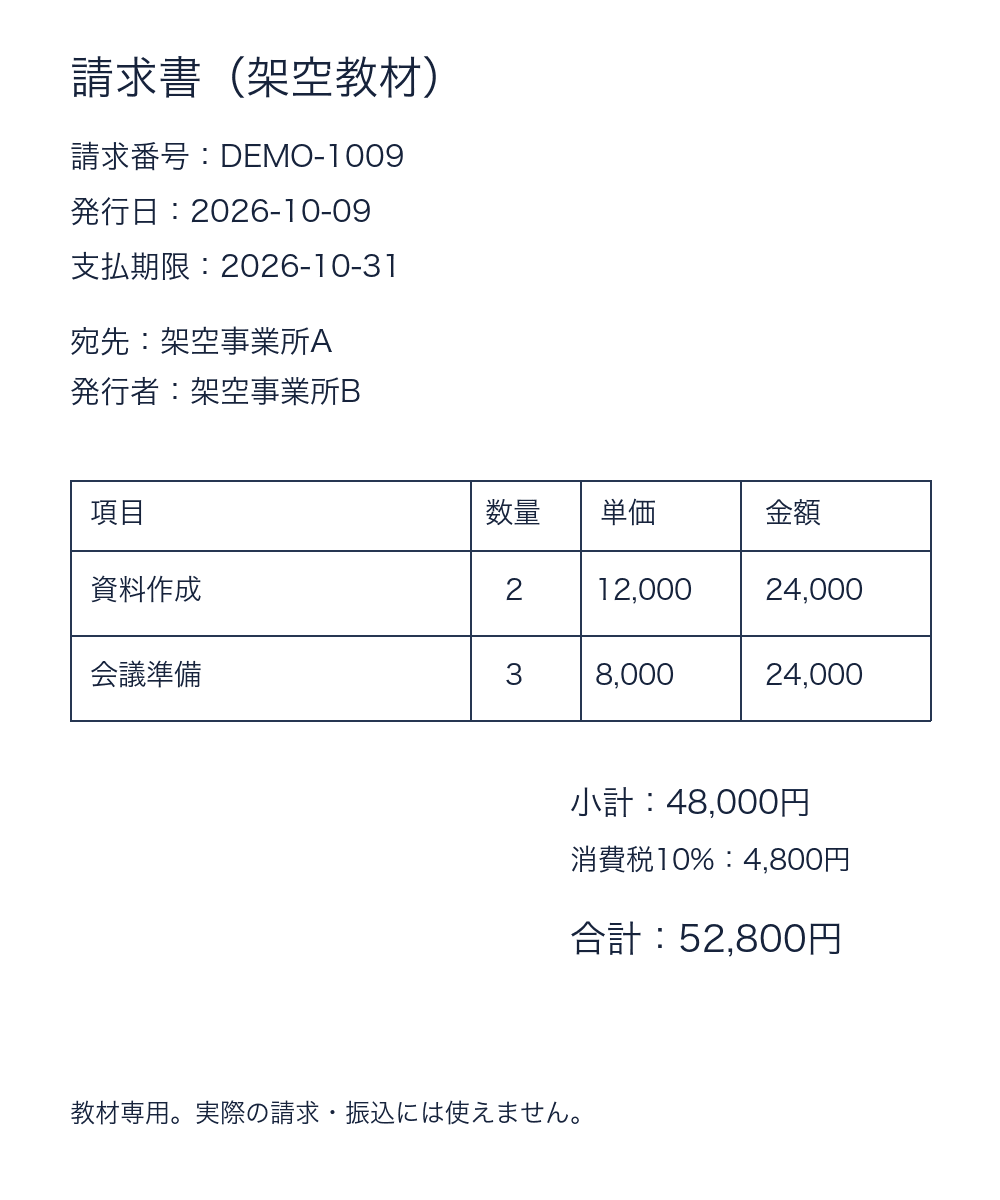
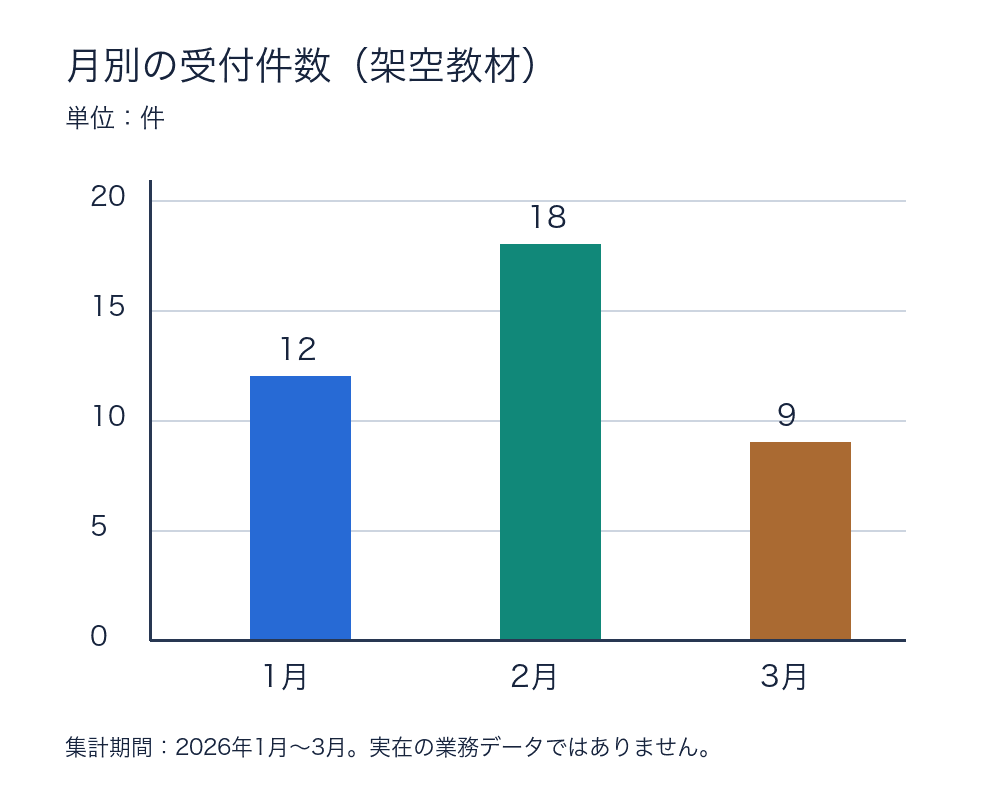
文字を大きくしたきれいな自作PNGで、請求書は1000×1200px、グラフは1000×800pxです。かすれたスキャン、手書き、縦書き、複雑な帳票は含みません。グラフは棒の上に値も記した読みやすい例なので、目盛りだけから数値を推定する能力の試験でもありません。
実行機はApple M2 Ultra・192 GiBメモリのMacです。まずCPUのfloat32・4スレッドで試すと、請求書の通常モード1回に約503秒かかりました。明細と合計は一致しましたが、続く生成は途中で止め、同じ画像・正解・重みを使うApple GPU(MPS)のfloat32試行へ切り替えました。以下の4条件の比較は、このMPS試行だけの結果です。CPUの完了1回と中断の記録も教材に残しています。OSはmacOS 27、Python 3.12.10、torch 2.14.0、Transformers 5.19.0.dev0、torchvision 0.29.1、Pillow 12.3.0です。使った重みはリビジョン4a953edfc77f0e435532c503dd69dd74663d44c3に固定しました。これは最低動作条件の検証ではありません。
画像ごとに通常・groundingを各1回、計4回。temperature=0.2とthinking無効は公式モデルカードの例に従い、seed=0と最大生成1536トークンは今回の試験条件として設定しました。乱数の種を固定しても、ライブラリや計算環境が違えば同じ文章になるとは限りません。推論はOS側で外部通信を遮断し、公開モデルの取得後に行いました。
実測:文字・表・位置を別々に照合する
MPSでの4回は、いずれもエラーや生成上限での打ち切りなく終了しました。正解は元画像と事前固定した期待値に照らして確認しています。
| 入力とモード | 今回確認できた内容 | 1回の処理時間 |
|---|---|---|
| 請求書・通常 | 明細2行の数量・単価・金額、税・合計、番号と日付が一致 | 15.42秒 |
| 請求書・grounding | 同じ内容が一致。表に種別と座標が付いた | 13.75秒 |
| グラフ・通常 | 12・18・9を含むASCII風の図。HTML表にはならなかった | 6.17秒 |
| グラフ・grounding | 1月12件、2月18件、3月9件の対応をHTML表として取得 | 9.12秒 |
時間はモデル読込を除き、画像読込・前処理・生成・出力の復号を含みます。順番に各1回だけ実行した値で、速度比較用の平均ではありません。
請求書の表はと出力されました。実画像へ戻すと左上(66,477.6)、右下(930,721.2)pxで、描いた表の範囲(70,480)〜(930,720)pxをおおむね囲みます。グラフはに続いて月別の表が出ました。位置と内容の両方を、同じ原画像で確かめられます。
ただしグラフの注記は、通常・groundingの両方で原文の「実在の業務データではありません」が「実際の業務データではありません」に変わりました。数値が合っても全文が完全に一致したわけではありません。今回はこの誤りを修正せず、生応答へ残しています。
この試験で自動集計する「11文字列の存在」と「座標の構文適合」は、OCRの正答率ではありません。たとえば24,000という文字がどこかにあっても、資料作成の行と会議準備の行に正しく結び付いているかは別です。グラフの12・18・9も、目盛りやばらばらの文字として出るだけでは、月別データを取り出せたと判定しません。
また、座標が0〜1000に収まり、左上より右下の値が大きくても、正しい領域を囲んでいるとは限りません。教材には原画像と生応答を同梱しています。集計結果だけを見るのでなく、金額の行、月と値、枠の位置を読者自身が見比べられます。
教材で再集計し、自分の環境で試す
検証用教材ZIPをダウンロードして展開してください。モデル重みやフォントは含めていません。まずはAIを動かさず、保存された4回分の結果を検査できます。展開先で次を実行します。
python3 test_evaluate.pypython3 evaluate.py --responses observed/raw.responses.jsonl --output my-evaluation.jsonこの処理はPythonの標準ライブラリだけを使い、通信も推論も行いません。入力画像と正解が事前固定したものと同じかをSHA-256で照合し、文字列と座標を再集計します。新たに作る評価ファイルが既にある場合は上書きせず終了するので、別名を指定してください。表の対応や領域の妥当性はexpected.jsonと画像で人が確認します。
モデルを再実行する場合は別途、公式重みと依存ライブラリを用意します。Hugging Faceのhfコマンドを利用できる環境なら、次のようにリビジョンを固定して取得できます。ここでのダウンロードにはインターネット接続が必要です。
hf download lightonai/LightOnOCR-3-0.8B \ --revision 4a953edfc77f0e435532c503dd69dd74663d44c3 \ --local-dir ./modelpython3 run_mps.py --model-dir ./model --output-dir my-new-resultspython3 evaluate.py --responses my-new-results/raw.responses.jsonl --output my-new-evaluation.jsonrun_mps.pyはMPSを利用できるMacでローカルの画像とモデルを読み、APIキーや有料のモデルAPIを使いません。必要ファイルがなければ、自動取得して補うのでなく失敗します。推論用の出力先も空のフォルダに限定しています。依存関係の導入は公式モデルカードを確認してください。記事と異なる環境の結果は別の試行として残します。
PDFを試す場合、公式は400 DPIで画像化し、縦横比を保って長辺2048pxにする前処理を案内しています。本教材のPNGはこのPDF変換を通していません。実際のスキャンを持ち込む前に、傾き、解像度、余白なども条件として記録すると、どこで読めなくなったかを追いやすくなります。公式モデルカードの前処理
業務へつなぐなら、自動転記の前に確認を挟む
導入時は「OCR→項目への整理→人の確認→保存」の順で試すと、問題の場所を見つけやすくなります。まず合計や支払期限など、間違うと困る項目を決めます。次に、単価×数量と明細額、小計と税と合計が合うかを別の計算で調べます。OCRモデルの出力に計算まで任せきる必要はありません。
グラフも、取り出した表をそのまま月報に流し込まず、月の抜け、単位、桁、最大値の月を照合します。位置情報はその確認箇所を示す手掛かりになります。文書検索への接続は画像やPDFを扱うRAG、取り出した情報を検索できるかの検収はEmbeddingGemma 2の日本語検索試験も参考になります。
公開重みはApache 2.0で、研究と商用利用が案内されています。ただし、モデルが無償で取得できることと、運用費がゼロであることは別です。重みだけで約1.71 GBあり、今回のfloat32展開にはさらにメモリを使います。計算機、電力、資料の前処理、誤りの確認にも負担があります。公式の速度や処理費の数値を、そのまま手元のCPUの見積もりには使えません。