
「在宅で会社のシステムにつなぎたい」と尋ねたとき、題名にその言葉がなくても「MacのVPN接続」を探せるか。さらに「売上が増え続けている図」と日本語で入力して、画像のグラフも見つけられるか。Googleが2026年10月6日に発表したEmbeddingGemma 2は、こうした検索を端末上で組むためのモデルです。公式発表
今回は架空の社内文書10件と自作グラフ4枚を用意し、日本語の質問で検索しました。答えのある文書8問はすべて最上位に入りましたが、グラフは取り違えがありました。また、資料に答えがない質問でも検索順位は返ります。実際の入力・正解・保存結果を教材として公開し、どこまで確かめたかを説明します。
文章も画像も、意味を表す数値に変える
は、文章や画像を意味の特徴を表す数値の並びへ変換する仕組みです。EmbeddingGemma 2は文章、コード、画像、音声、動画を共通の768次元の空間へ写します。「768次元」は1件を768個の数値で表すという意味です。質問と資料の数値が近いかを比べ、候補を並べる検索に使えます。
全体は7.4億パラメータで、文章用2.7億、画像用1.7億、音声用3億の構成です。必要な種類の入力に合わせて読み込む部分を選べます。Googleは100を超える言語への対応を説明していますが、日本語のあらゆる業務で同じ品質を保証するものではありません。今回も日本語の短い自作例を確かめた範囲に限ります。公式モデルカード
モデルの重みはHugging Faceなどで配布済みで、ライセンスはです。必要なファイルを先に取得すれば、検索をローカルで実行する構成を作れます。モデルのローカル利用にAPIの従量料金はありませんが、初回のダウンロード、保存容量、端末のメモリや処理時間は必要です。「小型」という説明だけで手元の環境に準備不要とは考えないでください。公式配布ページ
これは回答文を書くモデルではありません。検索した資料を生成AIへ渡すの検索部分にも使えますが、資料から正しい回答を作れるかは別に確認します。背景は社内ナレッジRAGで精度が出ない5つのパターンで整理しています。
正解を先に固定した文書とグラフ
文書は旅費、請求書、VPN、Wi-Fi、パスワード、休暇、会議室、備品、ファイル保管、イベント参加の10件です。いずれも架空の社内手順で、実際の会社の規則ではありません。質問10問のうち8問には対応する文書を決め、残る2問は、資料に答えが存在しない問いにしました。
| 日本語の質問例 | 事前に決めた検収条件 |
|---|---|
| 出張から戻ったあと、立て替えた電車代はいつまでに申請する? | 「出張旅費の精算」を探す |
| ログイン用の合言葉を忘れた。誰に再発行してもらえばいい? | 「アカウントの再設定」を探す |
| 社員食堂の今日の献立は? | 答えは10文書の中にない |
グラフは、増加、減少、横ばい、第2四半期を頂点とする変化の4枚です。色、題名、軸の見た目をそろえ、形を変えました。画像内の軸や題名は英語、日本語なのは検索する質問です。日本語の画像内文字を読む試験ではありません。各画像の数値も教材に含めています。
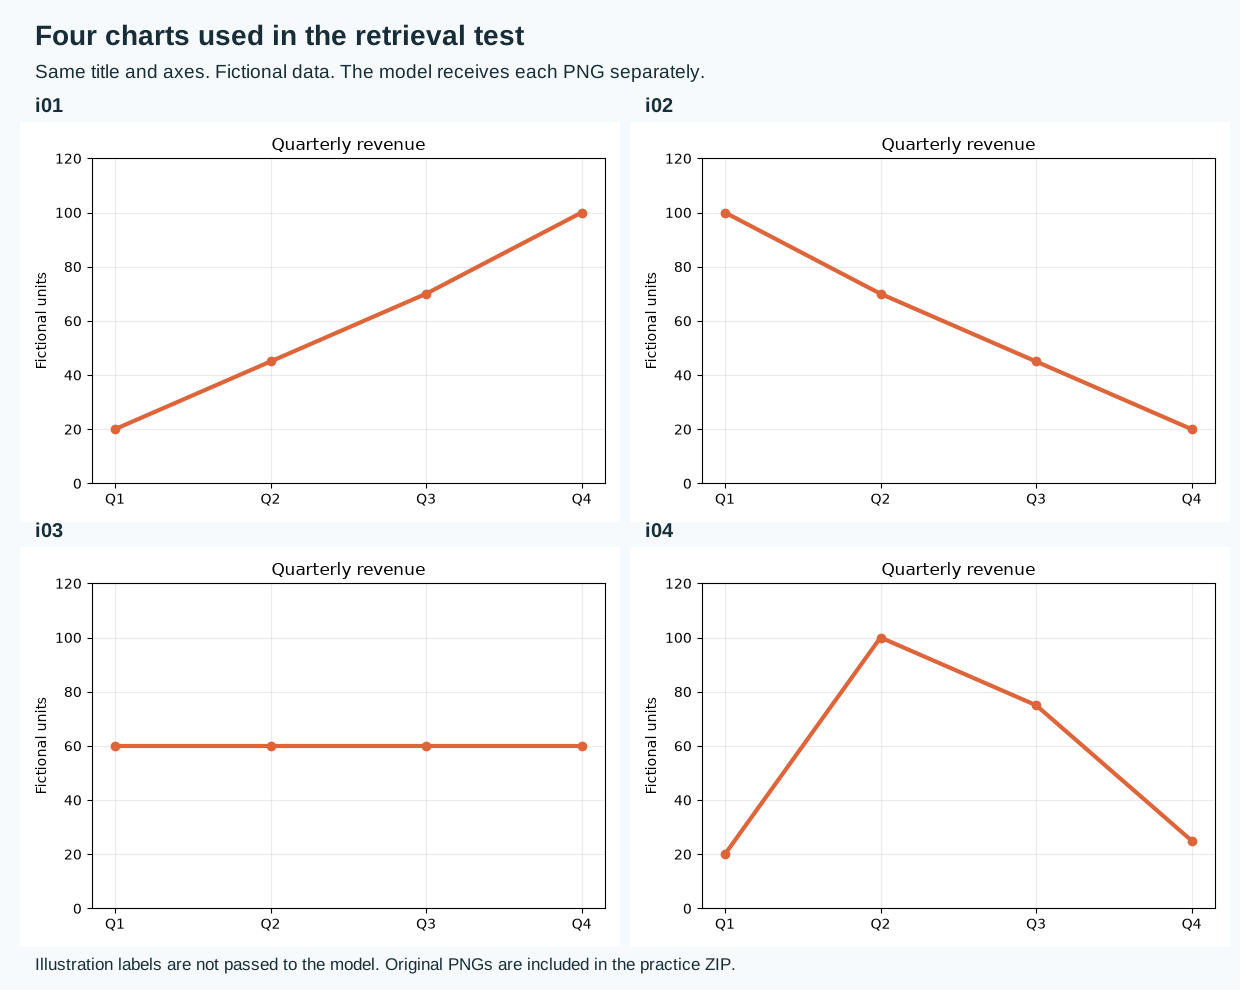
画像には「一貫して増えている」「下がり続けている」「ほぼ同じ水準」「第2四半期がピーク」という4問を用意しました。質問と正解は推論前に固定し、正解表はモデルへ渡していません。文書は文書10件、画像は画像4枚の中で順位を付けています。文章と画像が混在する一つの候補一覧の検索や、音声・動画の性能は今回試していません。
入力の書式と、次元を減らすときの注意
検索の質問と資料には、それぞれ役割を示す書式があります。公式の例では、質問に task: search result | query: を付け、資料には題名と本文を指定します。教材では質問側に prompt_name="SearchQuery" を使い、題名のある資料を次の形で渡しました。画像自体には文章用の接頭辞を付けません。公式READMEの入力書式
質問側の書式:task: search result | query: 出張から戻ったあと、立て替えた電車代はいつまでに申請する?
資料側の書式:title: 出張旅費の精算 | text: 出張費は帰着後10営業日以内に経費申請画面から申請します。領収書と訪問先、出張目的を添付します。今回は同じモデルから768次元の数値を一度作り、先頭256個または128個を残したものも比較しました。短くした後は、数値の並びの長さをそろえる正規化を行います。質問と資料の次元を同じにし、で順位を付けました。次元ごとに別モデルを動かした実験ではありません。
128次元なら、同じ数値型で保存するベクトル部分は768次元の6分の1になります。ただし、モデル本体の重みやアプリ全体のメモリが6分の1になるわけではありません。公式も128次元では画像などの品質低下に注意を促しています。保存量を減らした分だけ、必要な資料の順位が下がらないかを確認します。次元削減の公式説明
もう一つの注意は計算時の数値型です。公式は bfloat16 または float32 を指定し、float16 を使わないよう案内しています。値が不正になったり品質が落ちたりしても、分かりやすいエラーが出ない場合があるためです。今回の試用はCPU・float32で行いました。数値型の公式注意
実測結果:文書は8問一致、画像には取り違え
2026年10月7日、macOS 27のCPUを8スレッドで使い、各入力の埋め込みを1回ずつ取得しました。モデルは google/embeddinggemma-2 の固定版 914f7f89142e33e77833254d9c9b90c3cef7303b です。Python 3.12.10、PyTorch 2.14.0、Sentence Transformers 6.1.0、Transformers 5.19.0.dev0、torchvision 0.29.1を使用しました。Transformersは公式リポジトリの固定コミット 14e738b5d0cc69aa27a95dde272aea41fde44f2f です。環境と生の順位は教材へ記録しています。
Top1は正解資料が1位になった件数、Top3は3位以内に入った件数です。資料に答えがない2問を文書8問の分母へ混ぜず、画像4問も別に集計しました。
| 出力次元 | 文書 Top1 | 文書 Top3 | 画像 Top1 | 画像 Top3 |
|---|---|---|---|---|
| 768 | 8/8 | 8/8 | 3/4 | 4/4 |
| 256 | 8/8 | 8/8 | 3/4 | 4/4 |
| 128 | 8/8 | 8/8 | 2/4 | 4/4 |
全次元で、画像の「一貫して増えている」という質問に対し、第2四半期でピークを迎える画像を1位にしました。正しい右肩上がりの画像は2位です。128次元では「ほぼ同じ水準」という質問でも、横ばいの画像より右肩上がりの画像が上に来ました。どちらも正解画像が候補から消えたわけではありませんが、1位をそのまま採用すると取り違えます。
さらに、答えのない「今日の献立」ではWi-Fiの文書、「返品商品の関税」では旅費の文書が1位になりました。768次元での類似度はそれぞれ0.587と0.614、128次元では0.701と0.740です。答えの存在が変わっていないのに数値は上がりました。類似度は正答確率ではなく、この2例から万能な合格ラインを決めることもできません。次元を変える際、以前のしきい値を無検証で引き継がないための確認例になります。
これらは少数の自作問題を1回ずつ処理した結果です。文書の8/8を一般的な日本語精度と呼んだり、4画像から他製品より優れている・劣っていると結論づけたりはできません。旧EmbeddingGemmaやキーワード検索との比較も行っていません。
教材は、再集計とモデルの再試行を分けて使う
検収教材ZIPをダウンロードできます。入力、別ファイルの正解表、事前固定したハッシュ、画像、実行コード、保存結果を含みます。モデルの重みは同梱していません。まずZIPを展開し、そのフォルダで保存結果を再集計すると、モデルをダウンロードせず結果表を確認できます。
python3 evaluate.py observedこれは保存された results.json と正解表を照合する処理です。Pythonの標準機能だけで動き、モデル推論や外部API呼び出しは行いません。入力のハッシュが一致するかも検査します。ただし、保存順位を数え直す作業であり、モデルが同じ結果を再び出すことの確認とは別です。
モデルも試す場合は、配布READMEの環境情報を参照し、対応ライブラリと固定版のモデルファイルを先に用意します。用意できたローカルフォルダを指定して、次を実行します。例のパスは自分の保存場所へ置き換えてください。
python3 run_model.py \  --model-dir /path/to/downloaded-model \  --output-dir observed-new \  --threads 8
python3 evaluate.py observed-new
実行コードはローカルファイルだけを読み、モデルを自動取得しません。未取得のファイルや非対応ライブラリがあれば失敗します。既存の出力フォルダは上書きせず、再試行ごとに新しい名前を使います。環境、入力、全順位を残し、質問を追加する場合も結果を見る前に別の正解表を作ってください。
社内へ持ち込むなら、最初は少数の公開可能な手順で、探したい根拠と答えのない質問をそろえると検収しやすくなります。検索結果には元資料への導線を付け、利用者が根拠を読み直せるようにします。機密資料を扱う段階では、モデルのローカル実行とは別に、検索対象のアクセス権も設計が必要です。権限付きRAGの考え方も参照してください。