
「この問い合わせは経理へ回すべきか」「申込カードの人数は定員を超えているか」。文章を長く書かせるより、決めた候補から一つ選んでほしい仕事があります。Liquid AIが2026年10月7日に公開したd1-3Bとd1-omni-600Mは、こうした判断向けのモデルです。モデルの重みが配布され、手元の端末で実行する構成を作れるようになりました。公式発表
今回は小さい実験版のd1-omni-600Mをローカルで動かし、日本語の問い合わせ6件と自作の申込カード画像4枚を検収しました。事前に決めた正解との一致は、問い合わせ2/6件、画像1/4件です。返り値の形式は整いましたが、複数部署への相談や「未集計」の画像を取り違えました。入力・正解・保存結果を公開し、この少数例で分かったことを説明します。
生成文の代わりに、選択肢の数値を返す
d1へ渡すのは、対象の文章や画像と、候補・段階の説明を添えた質問です。回答文を生成してラベルを抜き出すのではなく、候補に付けた数値から決められた型の返り値を組み立てます。
| 質問の型 | 向く仕事 | 主な返り値 |
|---|---|---|
| noul | 「払い戻しの依頼か」の二択 | Yes側の数値 |
| choice | 経理・情シス・人事などへの振り分け | 選択したID、confidence、候補別の数値 |
| score | 2〜10段階の評価 | 段階番号の期待値、候補別の数値など |
返り値は answers に入り、使用量は usage に入ります。出力トークンは0ですが、文章・画像を読む計算がなくなるわけではありません。また、返答文を書かないので、選んだ根拠を自然文で説明する用途は別の仕組みが必要です。3B版の入力と返り値
choiceの confidence は、候補別の数値の最大値です。「日本語で80%正しい」と保証する数値ではありません。scoreも0始まりの段階番号の期待値であり、そのまま100点満点の評価ではありません。似た名前のAPIでも数値の意味は確認して使います。600M版の公式計算処理
判断向けモデルと実行ツールの違いは、Jev・Laya・Jeff・Micaの比較でも整理しています。今回の公開モデルと、Liquid AIが先に提供していたホストAPIのd1は、配布・実行の条件を分けて考えます。
3B版と600M版は、サイズ以外も違う
3B版は文章と画像向けです。600M版は文章と画像、または文章と音声を扱えますが、初期の研究用モデルとして公開されています。画像と音声を同じ要求に同時指定するとエラーになります。軽いから3Bの完全な代替になる、という説明はできません。公式モデルカード
| 項目 | d1-3B | d1-omni-600M |
|---|---|---|
| パラメータ数 | 31.2億 | 5.87億 |
| 入力 | 文章・JSON・画像 | 文章・JSON・画像、または音声 |
| 最大の文脈長 | 32,768トークン | 16,384トークン |
| 画像時の追加制限 | 600Mと同じ制限とは説明されていない | 対象文と質問の文章を896トークンへ切り詰め |
| CPUの公式例 | float32 | float32 |
| GPUの公式例 | bfloat16 | float16。bfloat16は避けるよう案内 |
600Mの画像へ長い規程を添えると、短い文章枠から条件が落ちるおそれがあります。今回は規則と入力を短くしました。計算時の数値型も違うため、3Bのコードを名前だけ変えて使わないようにします。必要なメモリ量は数値型や入力でも変わります。
両方のカードに日本語の言語タグがありますが、これを日本語の全用途での精度保証とは読めません。特に600Mの音声は、英語話者とアシスタントの依頼を使って学習したと明記されています。入力は16kHzのモノラルで、音声は30秒に切り詰められます。今回は音声を試しておらず、日本語の電話や会議に使えるとは結論づけていません。
先に固定した、日本語10件の検収
分類規則は英語で書き、経理(精算・請求等)、情シス(アカウント・PC等)、人事(休暇・福利厚生)、総務(会議室・備品)、要確認の5択にしました。二部署以上が必要な相談と情報不足は human_review を選ぶよう指定しています。
| 入力の例 | 人が先に決めた正解 |
|---|---|
| 出張の立替交通費を精算したい。提出先だけ知りたい | accounting |
| 会社のWi-Fiにつながらないので設定を確認してほしい | it |
| 交通費の精算方法と、業務PCの修理窓口をそれぞれ知りたい | human_review |
| 昨日お願いした件を進めて。詳細はあとで送る | human_review |
「要確認」は依頼の内容からも選べる候補です。confidenceが高くても、存在しない事実を補って部署を決めてよいわけではありません。
画像は日本語で「申込人数」「定員」と書いた4枚です。人数は28/30、30/30、32/30、未集計/30。候補は定員未満・同数・超過・要確認にしました。「未集計」は0人とは違います。画像の人数を入力文にも書くと画像を読んだか分からなくなるため、本文には「社内勉強会の申込カードです」とだけ添えています。
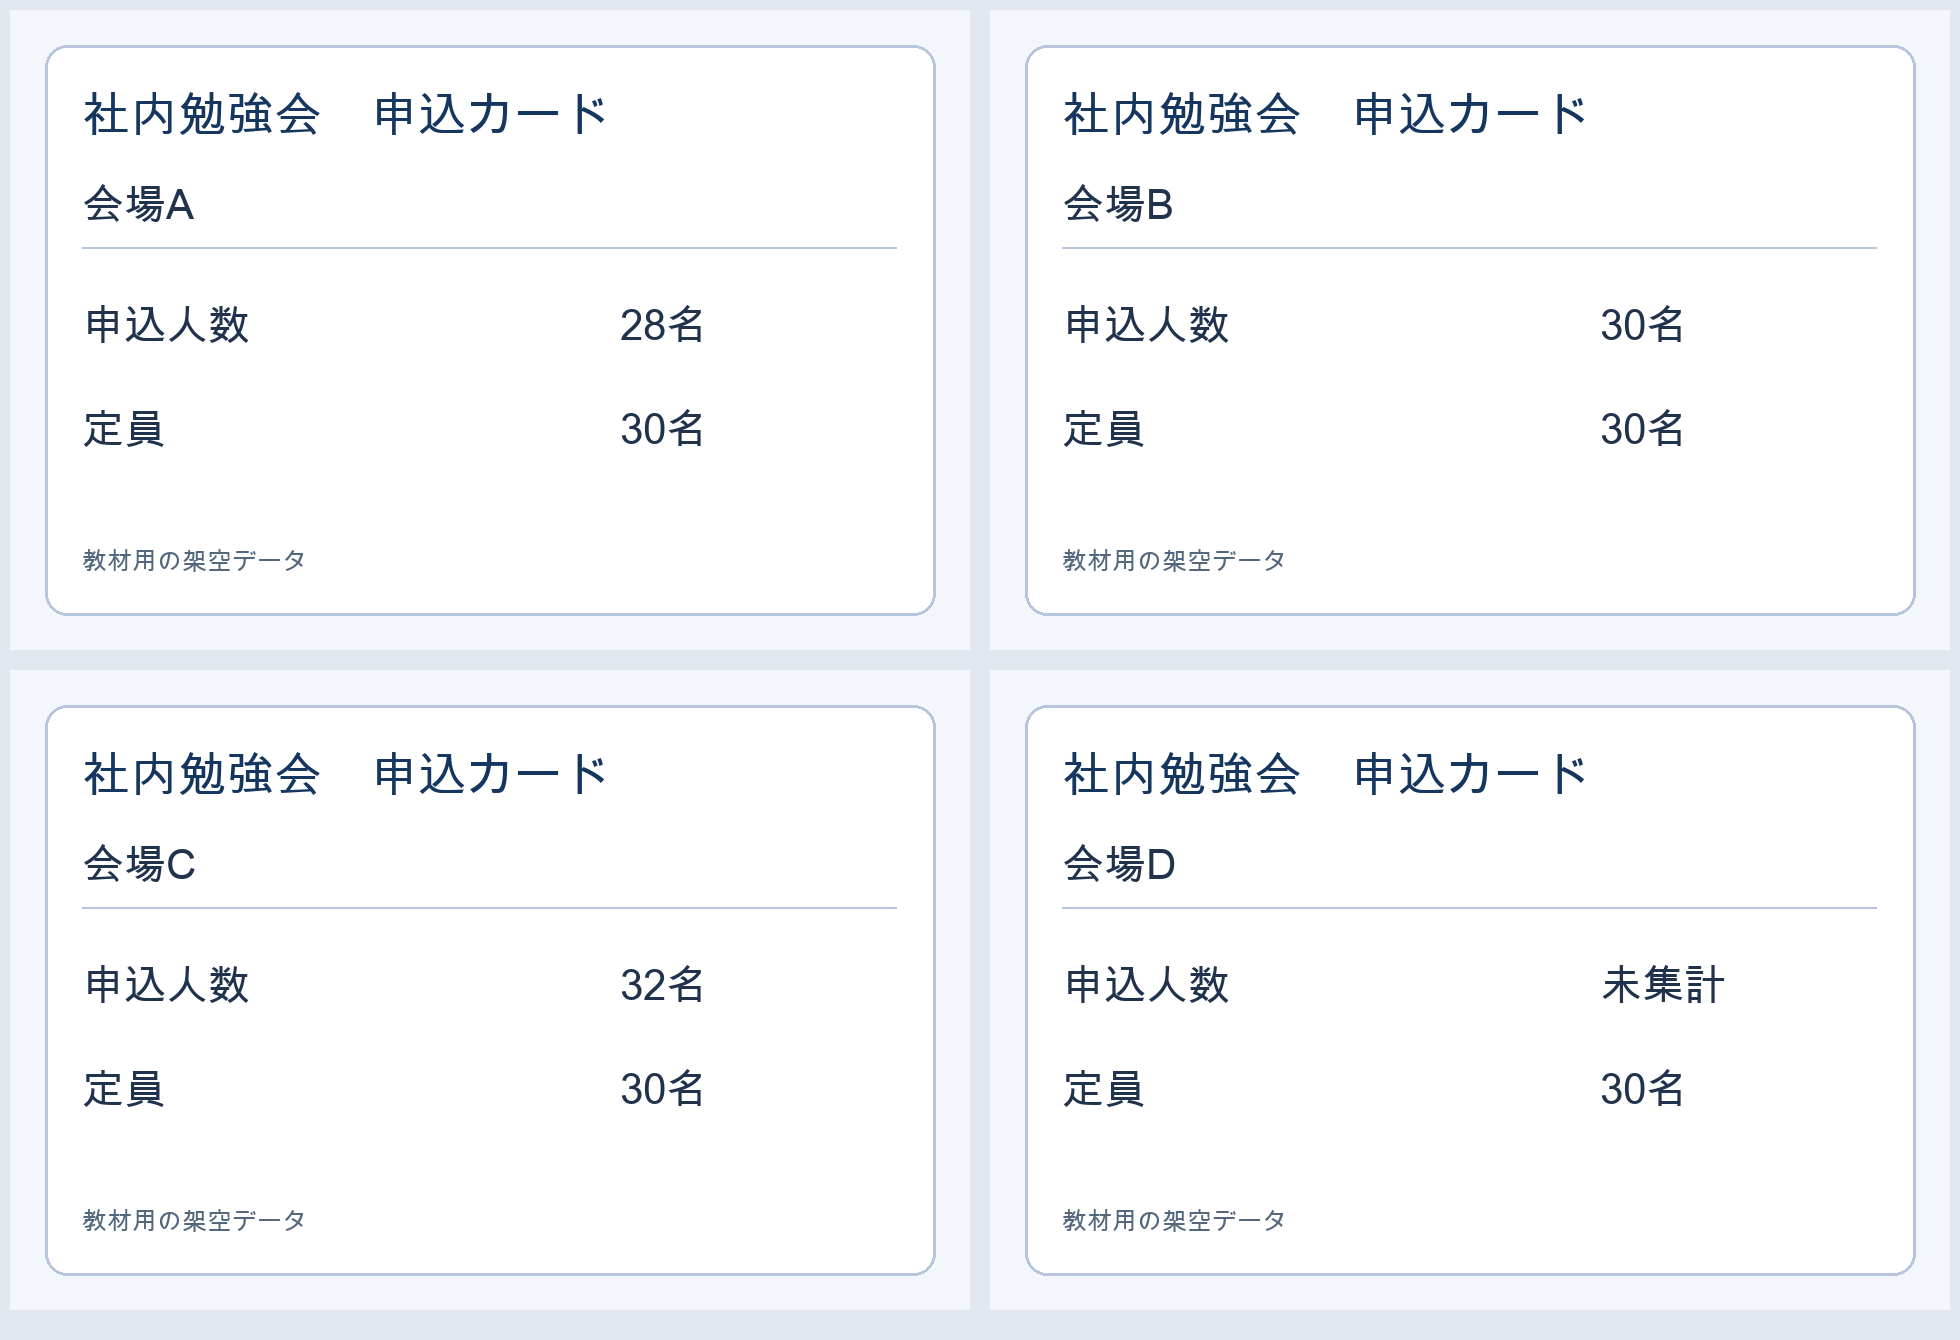
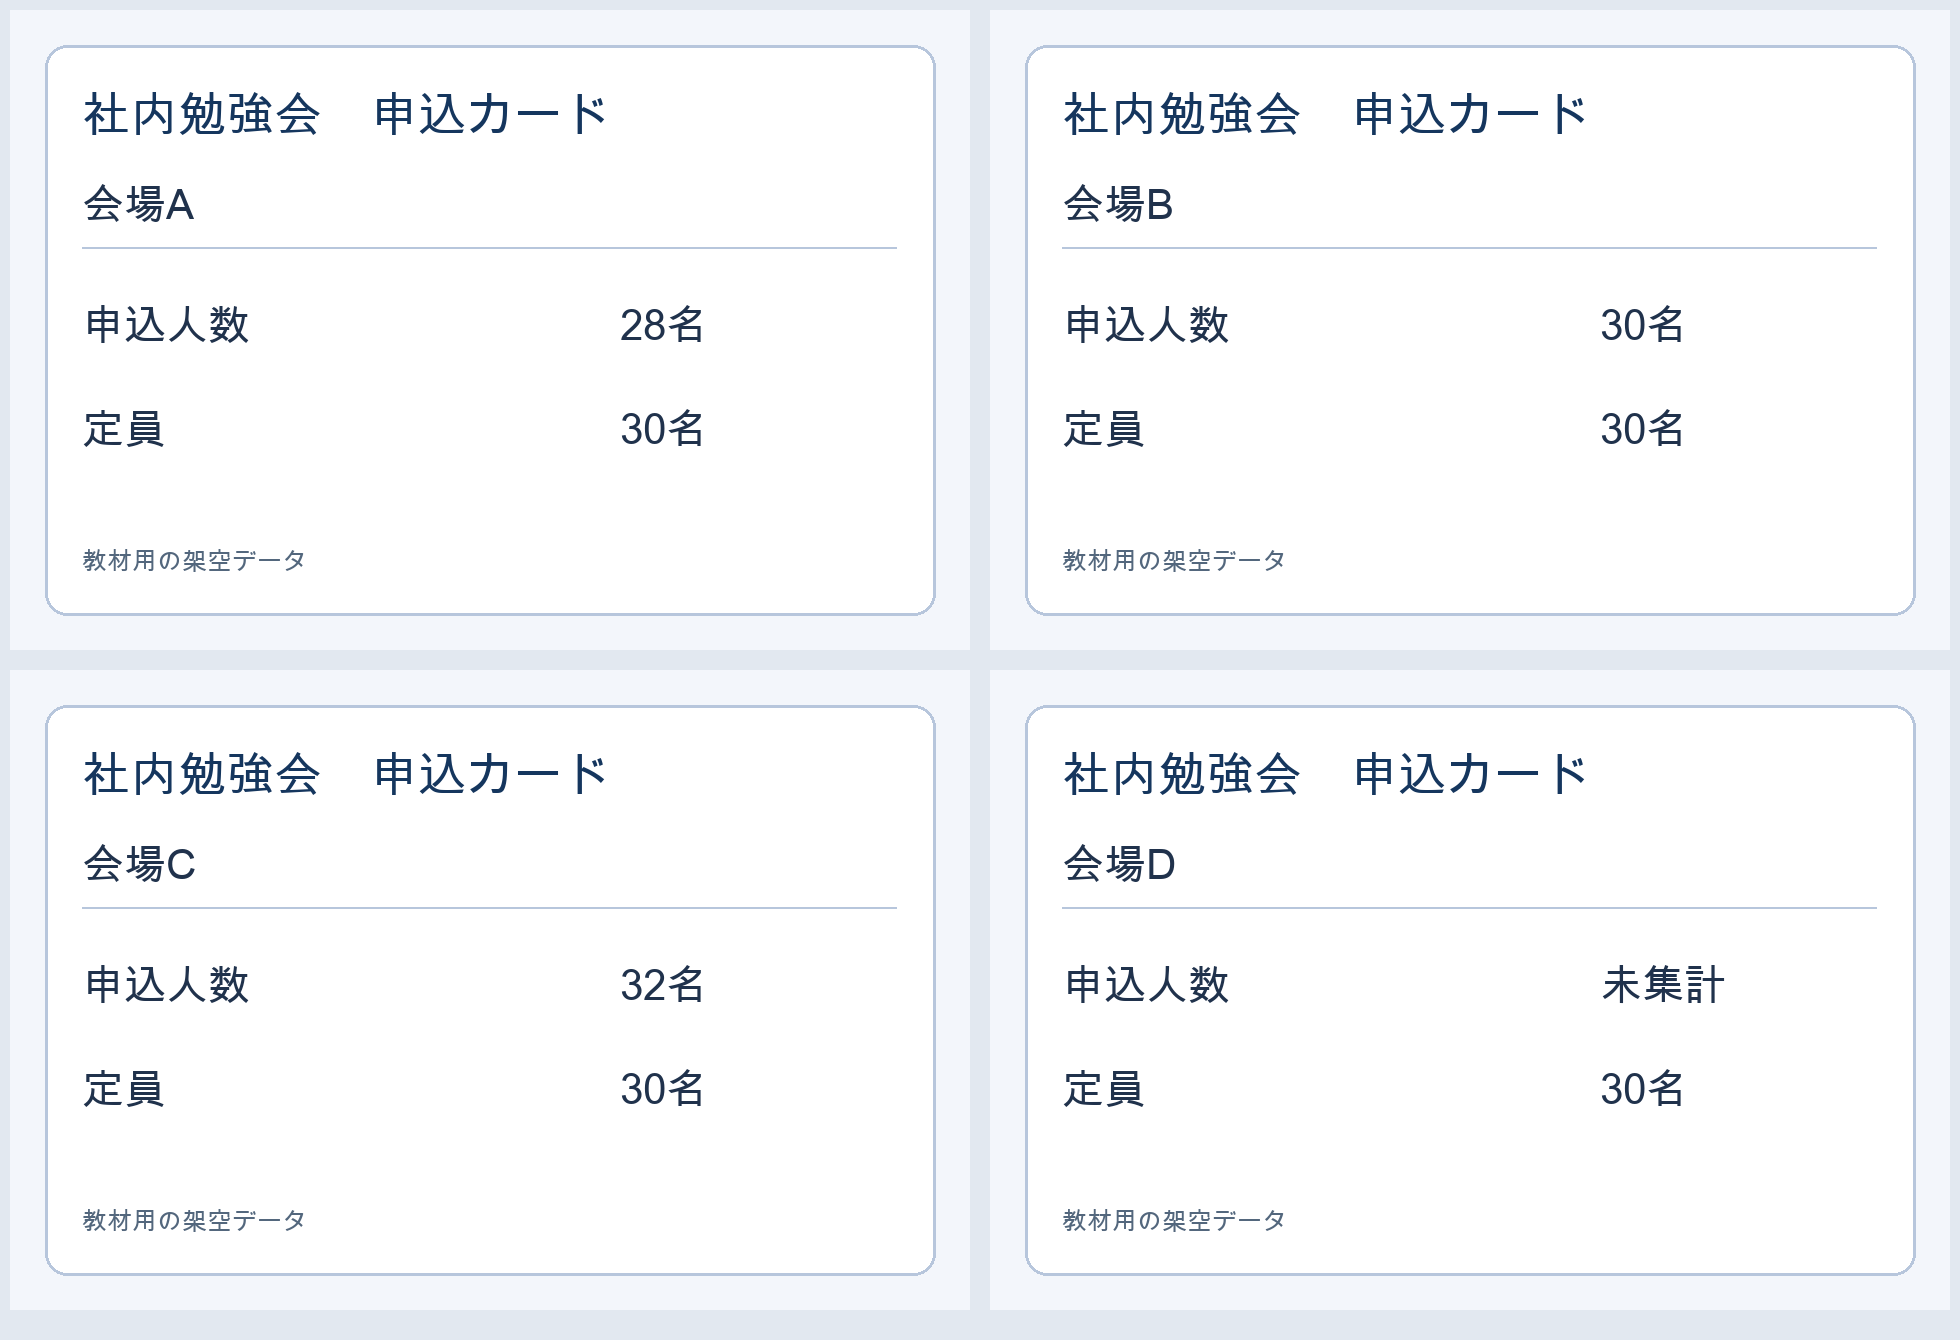
入力と人手の正解は別ファイルにし、実行前のSHA-256を保存しました。正解表はモデルへ渡しません。画像もすべて架空の自作素材です。読み取り、大小比較、情報不足への対応を確かめる少数例であり、現場の帳票全体を代表する問題集ではありません。
実測:形式は10件とも正常、正解との一致は3件
2026年10月8日、Apple M2 UltraのMacで600M版の固定版 02b55d7076f15129e59ab3f94783f32c4b088674 を実行しました。CPU・float32・4スレッドで各1回です。macOS 27、Python 3.12.10、PyTorch 2.14.0、Transformers 5.19.0.dev0を使用し、詳しい環境は教材へ記録しました。3B版、ホストAPI、音声、英語への翻訳版は試していません。
| 入力 | 人手の正解 | 600M版の選択 | 一致 |
|---|---|---|---|
| T01 交通費の精算 | 経理 | 要確認 | × |
| T02 Wi-Fiの不具合 | 情シス | 要確認 | × |
| T03 有給の申請手順 | 人事 | 人事 | ○ |
| T04 会議室予約 | 総務 | 総務 | ○ |
| T05 精算とPC修理 | 要確認 | 情シス | × |
| T06 用件の詳細が不足 | 要確認 | 人事 | × |
| V01 28名/定員30名 | 定員未満 | 超過 | × |
| V02 30名/定員30名 | 同数 | 超過 | × |
| V03 32名/定員30名 | 超過 | 超過 | ○ |
| V04 未集計/定員30名 | 要確認 | 定員未満 | × |
T05は二部署への依頼ですが、情シスだけを選び、confidenceは約0.714でした。T06も用件を補わず要確認に戻してほしい例ですが、人事を選びました。画像では3枚を「超過」とし、未集計のカードは「定員未満」としました。この結果だけでは、日本語の読み取り、数値比較、分類規則のどこが原因かは切り分けられません。
指定外のラベルや不正な数値は形式の失敗、ラベルが正しくても担当や人数比較が違えば内容の失敗です。両者を分け、実行エラーも記録に残します。この少数例から一般的な日本語精度や安全なしきい値は決められません。
モデル読み込みは約1.156秒、文章の最初の呼び出しは約446ms、続く5件は約117〜121msでした。画像4件は約2.17〜2.51秒です。いずれも各1回の観測で、呼び出し時間にモデル読み込みと画像ファイルを開く時間は含めません。公式3B版の8ms等は別モデル・別機材・条件付きの提供側測定で、今回の比較対象ではありません。3B版の測定条件
教材から試す手順と、ローカル利用の条件
問い合わせ・画像の教材ZIPには、入力、正解、画像、固定ハッシュ、実行コード、保存結果をまとめています。モデル重みは含めません。展開したフォルダで次を実行すると、素材と保存結果を再集計できます。Pythonの標準機能だけを使い、通信やモデル推論は行いません。
python3 validate_fixture.pypython3 evaluate.py model-results.json再集計は保存値を数え直す処理です。モデルも試す場合は、READMEの環境と固定版を用意し、python3 run_local.py --model-dir 保存先 --output 新しい結果.json を実行します。自動ダウンロードや既存結果の上書きはしません。次は読み込み済みの model に教材T01を渡す部分です。正解表は読み込みません。
import jsonfrom pathlib import Path
data = json.loads(Path("inputs.json").read_text(encoding="utf-8"))case = data["cases"][0]questions = {name: data["questions"][name]             for name in case["question_names"]}result = model.system_one(case["state"], questions)print(result)
公式の600M版はTransformers 5.15以上、PyTorch、画像用のPillow等を使います。独自コードを読み込む trust_remote_code=True が必要なので、通常のチャットモデルと同じ手順だけで動くとは考えず、確認した版を固定します。必要なファイルを取得した後のローカル推論と、初回のダウンロードは別の処理です。公式の導入例
ローカルで動かす場合はホストAPIの従量料金は発生しませんが、端末の計算資源や保存容量は必要です。ライセンスもApache 2.0ではなくLFM Open License v1.0で、年商1,000万米ドルを基準に商用利用を制限する条項があります。「重み公開」を「すべての企業で無条件に商用利用可能」と読み替えず、導入時に利用主体と原文の条件を確認してください。配布ライセンス
業務では、まずラベルを担当者が確認する運用にします。今回は予約変更や転送はしていません。画像を使う判断処理は、Cloudflare Clefの記事も参考になります。