
「この問い合わせは請求担当に回すべきか」「返金を求めているか」。こうした短い判断を返すモデルは、仕事の振り分けに使える可能性があります。ただ、APIから返った数値だけでは、どの選択肢に迷ったのか、質問の書き方が合っているのかを確かめにくいものです。
LLMxRayの新しい「Decision Lab」は、判断モデルに渡す文章と質問をブラウザで編集し、選択肢ごとの確率を棒グラフで見るための画面です。今回は小型モデルTev1 0.8Bを使い、日本語の架空の問い合わせ6件を実際に入力しました。分類は事前に決めた正解と6件とも一致しましたが、「返金してください」という依頼を取りこぼす結果も出ています。
日本語での運用に進める前に、成功例と失敗例を並べて確かめる。そんな用途で使うと、この画面の意味が見えてきます。
新しくなったのは「判断を観察する画面」
Decision Labは、2026年10月12日5時19分(日本時間)公開のv0.7.0で追加されました。LLMxRay自体の初公開ではなく、既存のローカルLLM観察ツールへの機能追加です。同日5時43分のv0.7.1では、別の「Embeddings」画面に画像の埋め込み機能が加わっています。Decision Labへ画像を渡せるようになった、という更新ではありません。
LLMxRayはモデルそのものではありません。文章を分類するのはOllama上で動かすTev1などの判断モデルで、LLMxRayは質問を組み立て、結果を表示する側です。今回の構成は「ブラウザ → LLMxRay → 同じMacのOllama → Tev1」でした。JevのAPIは使用していません。
公式ガイドでは、Ollama 0.35.1以降と判断モデルを使い、次の3種類を扱います。
| 質問の種類 | 返ってくるもの | 問い合わせでの使い道 |
|---|---|---|
| Choice | 選んだ項目、各項目の確率、confidence | 請求・アカウント・不具合などの振り分け |
| Yes / no probability | 条件に当てはまる確率 | 返金を明示的に依頼しているか |
| Score on a scale | 順序を付けた段階の期待値と分布 | 業務停止の範囲を0〜2で見る |
現時点のDecision Labには履歴保存や画像入力がありません。入力と結果を比較し続けたい場合は、別途記録を残す使い方になります。
準備と利用条件。今回はソース版で確認
LLMxRayはApache 2.0のオープンソースです。今回のように手元のOllamaとダウンロード済みモデルを使う構成では、クラウドAPIへの従量課金は発生しません。初回の取得用の通信、保存容量、実行するPCは必要です。公式リポジトリ
ブラウザで操作しますが、モデル実行にはOllamaが動く環境が必要です。OllamaはmacOS・Windows・Linux向けに提供されています。本記事で実測したのはApple M2 Ultra搭載Mac、メモリ192GB、macOS 27、Ollama 0.40.0、Node.js 23.11.0です。これは検証機の構成であり、192GBが必要という意味ではありません。WindowsとLinuxでの動作は今回未検証です。
モデルはtev1:0.8bで、取得されたMLX版は約797MBでした。名称が同じでも実行方式によって取得物は異なり、モデルページには別の実行方式の配布物も載っています。今回の結果はMLX版の条件に限ります。
モデルの利用条件はアプリのライセンスと別です。Together AIのTev1 0.8B公式モデルカードは、基盤モデルをApache 2.0とする一方、追加学習した重みの公開ライセンスは策定中と記載しています。業務への本格導入や再配布に進む際は、重みの条件が確定したかを改めて確認してください。
導入には一点注意があります。公式npm配布物v0.7.1のサーバーでは、今回の環境でモデル一覧と判断APIがともにHTTP 404になりました。同じOllamaへの接続はソース版の開発サーバーから成功しています。原因の断定や、すべての環境で再現するとの判断はしていません。そのため、この記事では実行できたソース版の経路を紹介します。
Ollamaを起動し、ターミナルでモデルを取得します。ダウンロードとローカル実行に必要な容量を確保してください。
ollama pull tev1:0.8b続いてGitとNode.jsを用意し、バージョンを固定して取得します。Node.jsは同梱Viteの条件を満たす22.12以降などを使います。
git clone --branch v0.7.1 --depth 1 https://github.com/LogneBudo/llmxray.gitcd llmxraynpm ci --ignore-scripts --no-audit --no-fundnpm run dev -- --host 127.0.0.1ターミナルに表示されたローカルURLを開きます。既定ではhttp://127.0.0.1:5173です。標準の設定ではOllamaのlocalhost:11434へ接続します。別ポートのOllamaを使う場合は、vite.config.tsにある/apiと/v1の接続先を両方そろえます。接続設定のソース
今回の試用では既存環境と分けるため、モデル保存先を一時ディレクトリにし、Ollamaを11439、画面を5179で起動しました。LLMxRayの変更はこの接続先だけです。判断処理や表示のコードは変更していません。
まずは請求担当への振り分けを作る
v0.7.1では日本語UIを選べませんが、英語UIの入力欄へ日本語の本文と判断基準を入れられました。左メニューの「Decision Lab」を開き、モデルとしてtev1:0.8bを選びます。
「State」には判定対象の文章を入れます。以下は実際に使った架空の文章です。
10月分の利用料が同じ日に2回引き落とされました。重複分を返金してください。サービス自体は使えています。質問のキーをroute、種類を「Choice」にし、指示欄に次の文を入れます。
問い合わせの主な内容を選んでください。最も合う項目を1つ選び、合うものがなければotherを選んでください。候補欄は1行に1項目、名前: 説明の形式です。
billing: 請求、支払い、返金の問い合わせaccount: ログインやアカウント設定の問い合わせbug: ソフトウェアのエラーや動作不良other: どの分類にも当てはまらない問い合わせ「Decide」を押すと、結果が右側に表示されます。どの分類にも該当しない文章を無理に請求や不具合へ割り当てないため、今回はotherを用意しました。候補を1件だけにした場合はボタンが無効になり、送信前に不適切な設定を止められることも確認しました。
次に質問を追加し、キーrefund、種類「Yes / no probability」で「顧客は今この文面で返金を明示的に依頼していますか。返金不要、確認だけ、将来決めるという記述は依頼に含めません。」と指定します。同じ問い合わせに対する分類と返金依頼の判定を、一度に見られます。
6件の日本語実測では、返金依頼を取りこぼした
実測日は2026年10月12日です。入力前に期待する分類・返金依頼の有無・業務影響の段階を決めた6件を用意し、各1回、計6リクエストを画面から送りました。各リクエストでは3種類の質問をまとめています。実在する顧客情報は使っていません。
3つ目の質問severityには、「業務は止まっていない」「一人の業務が止まっている」「複数人または全員の業務が止まっている」の順に0・1・2の段階を与えました。
| 架空の問い合わせ | 期待した分類 → 出力 | 返金依頼「Yes」の出力 | 業務影響の期待値(0〜2) |
|---|---|---|---|
| T01 二重請求。「返金してください」 | billing → billing | 29.4% | 0.83 |
| T02 自分だけログインできない | account → account | 7.6% | 1.24 |
| T03 営業部全員が受注を登録できない | bug → bug | 3.7% | 2.00 |
| T04 請求書払いへ変更。返金は不要 | billing → billing | 2.6% | 0.72 |
| T05 未契約で説明会の日程を尋ねる | other → other | 3.3% | 0.49 |
| T06 二重請求か確認だけ。返金は後で決める | billing → billing | 2.3% | 0.50 |
分類は6件とも事前のラベルと一致しました。一方、返金を明示的に求めるT01のYes出力は29.4%。仮に「50%以上なら返金依頼あり」という単純なルールで処理すると、この1件を見逃します。残り5件はもともと返金依頼なしの例なので、これだけで実際の問い合わせ全体の精度を評価することもできません。
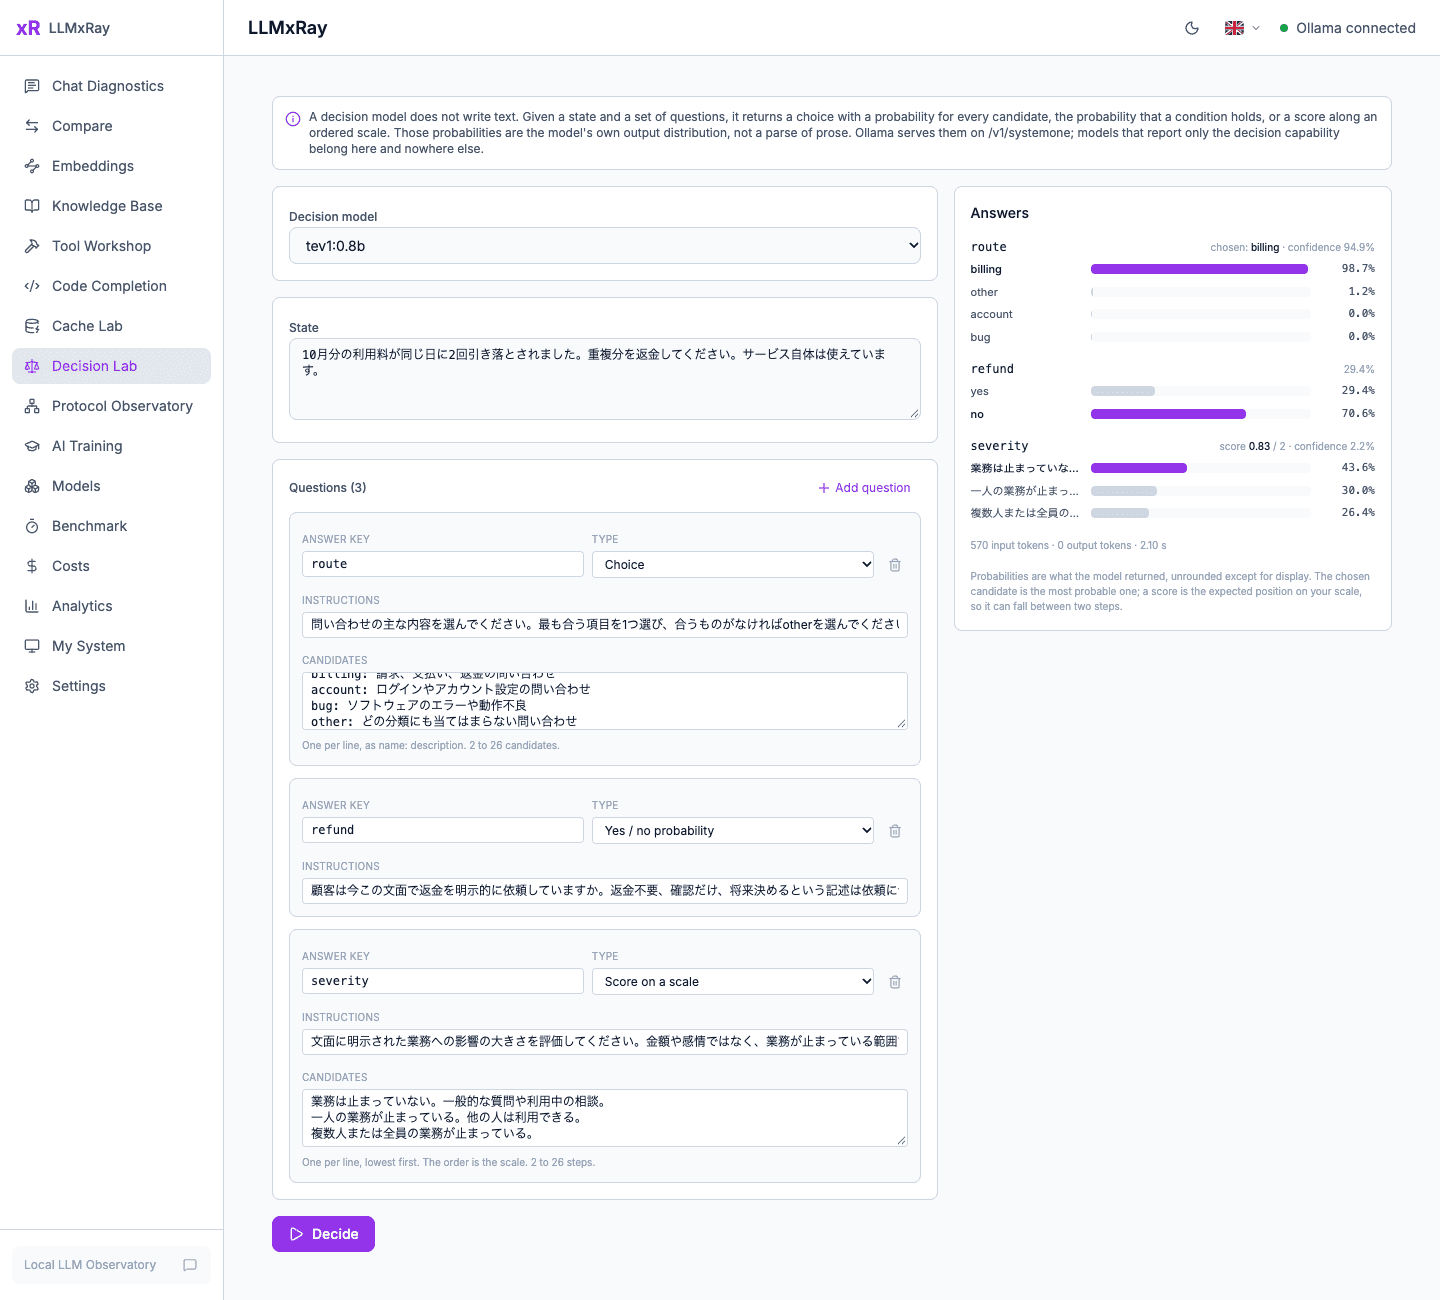
同じ文面でも、担当部署への分類と返金依頼の検出は別の問題です。分類が合ったからといって、隣の質問まで合っているとは限りません。この結果を画面で並べて見られる点が、導入前の確認に役立ちました。
今回使った日本語の指示、小型モデル、6件の架空例に限った観察であり、Tev1全体や他モデルの日本語性能の結論ではありません。モデルの説明も、英語以外の言語や確率の校正などを十分に検証していないとしています。
確率の棒とconfidenceを、そのまま正解率にしない
Decision Labの数値を見るときは、何の質問に付いた値かを最初に確かめます。T01では分類routeのconfidenceは約94.9%でしたが、これは返金依頼refundの信頼度ではありません。refundには今回、confidenceという別のフィールドは返っていません。
また、モデルのconfidenceは、候補への出力がどれだけ集中しているかを表す値です。「この答えが正しい確率」として検証された数字ではありません。高い値が出ても、手元の正解例と照合する工程は必要です。Tev1の出力仕様
段階スコアにも違いがあります。T01の業務影響は0.83でしたが、最も確率が高い段階は0です。0.83は各段階の番号に確率を掛けて足した期待値であり、四捨五入して「段階1と判定した」と読み替えると結果の意味が変わります。棒グラフの広がりと最頻の段階を一緒に見てください。
仕事で試すなら、最初は担当者の判断を置き換えず、既存の受付記録と並べる用途が向いています。問い合わせの種類ごとに正解を用意し、「取りこぼすと困る依頼」が含まれる例を増やす。質問やモデルを変えたら同じ例で比較する。LLMxRayは、その準備を目で見ながら進めるための道具として使えます。
教材には保存済みの出力を検算するPythonスクリプトも入れています。この検算は新たにモデルを動かしたり、正確性を保証したりするものではありません。元の実測と同じ数値から表を作れること、段階スコアの計算を確認できることが目的です。