
スキャンした仕様書の表が次のページへ続いている。OCRで文字にできても、表のつながりや見出しの階層を直す作業が残る。Baiduが2026年10月27日に公開した Unlimited-OCR-2 は、こうした長い文書の構造を読み取るための画像・言語モデルです。日本語の架空納品書1枚を公開デモで試し、読み取り結果と後処理まで確認しました。
今回読めたのは、白地・横書きの簡単な日本語教材1枚です。縦書き、手書き、複雑な表、数百ページの日本語文書は未検証です。また、公開デモへのアップロードは外部送信になります。社内にモデルを配置するローカル運用とは区別してください。Mac上でのモデル推論も試していません。
公開日は公式モデルカードのRelease欄で確認しました。発表時刻とタイムゾーンは記載されていないため、「何時間前の発表」とは断定しません。初代は6月22日、今回の2は10月27日の更新です。モデル保存先の作成日時や、Redditに投稿された日時をリリース日時とは扱っていません。確認日は2026年10月28日(日本時間)です。
何が新しい? ページをまたぐ文書を読み続ける工夫
OCRは、画像の中の文字を機械で扱える文字データへ変える技術です。Unlimited-OCR-2は文字だけでなく、見出し、表、図の位置や読む順番を扱う文書解析モデルです。画像と文章の両方を扱うモデルをVLMと呼びます。一般的なチャット用LLMをそのまま置き換える製品ではありません。
技術論文の3.1〜3.3節によると、初代は直前の文章への参照を絞っても、それ以前のページ画像への参照量が増える課題を残していました。2では SR-SWA(Sparse Reference Sliding Window Attention) を導入し、直近の文章に加えて、対象ページの画像から必要な部分を選んで参照します。画像の参照先を絞り、生成の負担を抑える設計です。
本を写すとき、今見ているページの必要な箇所に目を向けながら、直前に書いた文章も参照する、と考えると近いでしょう。任意の遠いページを自由に検索するという説明ではありません。ページ間の継続には、後述する分割処理の境界ページと末尾の文章情報を再利用する仕組みも関係します。どの情報を残すかによって読み違いは起こり得ます。
| 見たい点 | 初代からの差分・今回の注意点 |
|---|---|
| 長い入力 | 論文では初代に40ページの入力制限があり、2は百ページ級の評価へ進んだと説明 |
| ページをまたぐ構造 | 表や文章の続きを含め、文書全体として解析する設計 |
| 参照する情報 | 文章の直近部分だけでなく、画像側の参照も選択して負担を抑える |
| 実際の運用 | ページ単位の分割処理と境界付近の情報再利用を組み合わせる。時間・容量・出力設定が無制限になるわけではない |
「無制限」は、メモリーも処理時間も不要という意味ではない
モデル名のUnlimitedは、長さを伸ばしやすくする設計を表したものです。文書全体の入力画像、モデル本体、出力テキストなどは依然として資源を使います。1トークンを生成する際の負担を抑えても、ページが増えれば読む量と出力する量は増えます。
公式のSGLang設定例は10ページ単位の処理窓や、1ページ20,000トークンの出力上限を設定しています。トークンは、モデルが扱う文字列の小さな単位です。公式自身も、窓を小さくすると最大メモリー使用量を抑えられる一方、窓の境界をまたぐ表や文章の結合が難しくなると注意しています。読み取り速度だけでなく、境界で情報を落とさないかを調べる必要があります。
公開デモにも別の制限があります。確認したデモの実装では、1回の文書解析は最大8ページです。研究上の百ページ級評価と、ブラウザーから試せるページ数を混同しないでください。
論文の数字を読む:得意なのは何で、どこまで比較したのか
以下は編集部の比較実測ではなく、提供元の論文、表1〜4に載る結果です。総合スコアは複数の評価項目を集約した値で、「文字を何%正しく読めたか」と同じではありません。
| 評価 | 論文に載る結果 | 読み取るときの条件 |
|---|---|---|
| MPDocBench(最大30ページ) | Unlimited-OCR-2のOverallは84.59 | ページをまたぐ文章・表などを含む総合評価 |
| MarathonDocBench | Overallは77.06 | 提供元が新たに作った100文書、103〜300ページのベンチマーク |
| OmniDocBench v1.6(単ページ) | Overallは94.02。初代は93.92 | 同じ表にはOvisOCR2の96.47、TeleOCRの96.91もあり、単ページで一律に最高とは言えない |
| KVキャッシュの最大量 | 通常デコード47.00GB → 長文書向けデコード1.77GB | 同一系列の推論方式比較、同時処理数B=1。モデル全体に必要なGPUメモリーではない |
KVキャッシュは、文章を生成するときに再利用する中間情報です。「1.77GBのGPUで動く」と読み替えるのは誤りです。また、長文書の比較表には汎用VLMが多く、あらゆるOCR製品を比較した表ではありません。日本語だけの精度や、国内の帳票を対象とした成績は今回確認した資料には示されていません。
Redditの紹介スレッドでも、専用OCRとの比較条件やLightOnOCRとの違いに関心が寄せられています。利用者の感想は評価環境が統一されていないため、そのまま製品間の勝敗の根拠にはできません。
日本語の架空納品書を1枚試した結果
公式のHugging Face公開デモへ、編集部で作った1200×900ピクセルのPNG画像を送信しました。白背景、横書き、活字6行で、写真の傾きや複雑な罫線のない教材です。parse_pageをbaseモード、追加指示なし、max_page_tokens=2000で1回実行しました。これはクラウド上のデモ試用であり、このMacでモデルを動かした結果ではありません。
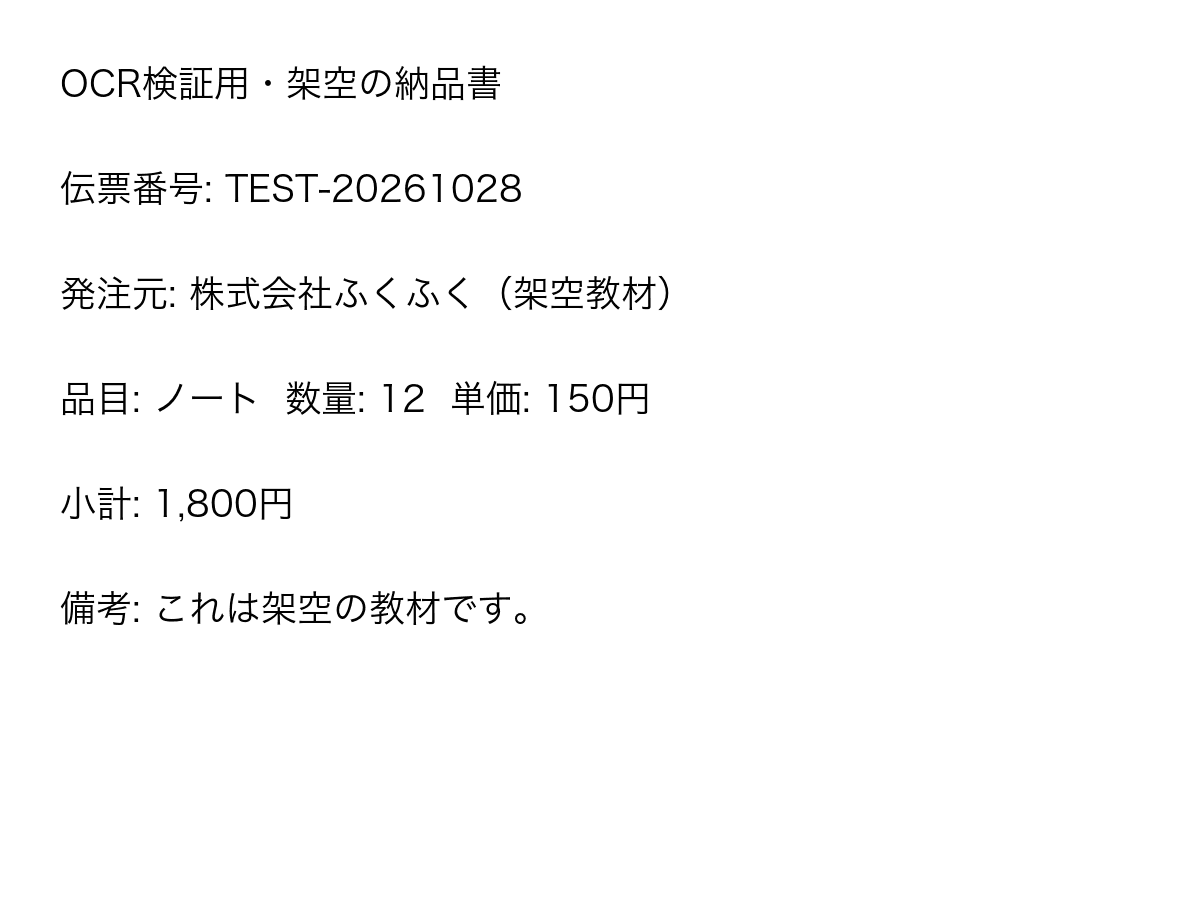
| 確認項目 | 教材の値 | 返された文字列 |
|---|---|---|
| 伝票番号 | TEST-20261028 | TEST-20261028 |
| 品目・数量 | ノート・12 | ノート・12 |
| 単価 | 150円 | 150円 |
| 小計 | 1,800円 | 1,800円 |
| 括弧・空白 | 全角括弧と行内の複数空白 | 一部が半角括弧・単一空白へ変化 |
主要な値は一致しましたが、元の文字列を空白や記号まで完全保存したわけではありません。デモのレスポンスに含まれるelapsedは10.9秒でした。これはデモが報告した内部処理時間で、通信・待ち行列を含む実用上の待ち時間や、他の端末での速度保証ではありません。今回は1回だけの確認なので、成功率や平均速度も算出していません。
出力は、そのままMarkdownとは限らない
今回、デモのmarkdownフィールドにも <BLOCK> などのタグが残っていました。公式の後処理ガイドにも、モデルが直接Markdownを出すわけではなく、ページ・ブロック・座標などの情報を含む文字列を出すと明記されています。アプリ側の欄の名前だけで、読みやすい文書が完成したと判断しないことが大切です。
<BLOCK>text[48, 186, 436, 231]<FORK>伝票番号: TEST-20261028編集部では公式の変換スクリプトを確認し、取得した出力に適用しました。標準Pythonだけで動く後処理で、今回はタグを除いた文章に変換でき、伝票番号・数量・金額が保たれました。これは文字認識を再実行した実験ではありません。誤って認識した文字をこの工程だけで直せるわけでもありません。
python3 utils/process_unlimitedOCR2.py --infer-dir raw --out-dir convertedスクリプトはページをまたぐ表の結合や重複見出しの除去も扱いますが、今回の単ページ教材では検証していません。また、生成されたMarkdownに図のファイル名が書かれていても、参照先の画像が揃っているかは別に確認します。保存後の文章だけでなく、ページ対応と添付ファイルまで確認して初めて次の工程へ渡せます。
ローカルLLMの観点:モデル公開と手元のMacで動くことは別
| 項目 | 確認できた提供条件 |
|---|---|
| 公開形式・ライセンス | モデルカードはMITを表示。重みを取得できる。配布コードと利用条件を確認して使う |
| モデル規模 | Hugging Face APIでは約33.44億のパラメーター。配布重みはBF16が中心 |
| 公式の動作確認例 | Python 3.10、torch 2.13.0、transformers 4.52.1、NVIDIA A800-80GB |
| 推論の入口 | Transformersのinfer / infer_multi。サーバー運用は公式がSGLangを推奨 |
| 対応OSの読み方 | 公式手順はCUDAを利用。OSごとの対応表や、MacのMetal・CPUでの動作保証は確認できない |
| 費用 | 重みの利用と、GPU・電力・保存容量・運用費は別。クラウドサービスの料金をモデルのMIT表記から推測しない |
動作確認例の80GBは、そのまま最低必要メモリーを意味しません。ただし、約3Bというモデル規模だけを見て「普通のノートPCで快適」とも言えません。ページ数、画像の解像度、タイル分割、同時実行数によって必要資源が変わります。今回の公開デモが動いたことも、Mac上での動作の証拠にはなりません。
公式手順では trust_remote_code=True を使い、配布側のPythonコードを実行します。SGLang用にも専用wheelが用意されています。社内環境へ入れる際は、モデルの版だけでなくコードと依存関係を固定して確認してください。手順の例が待ち受け先を0.0.0.0としていても、個人の試用で外部へ公開する必要はありません。ローカルホストや社内の限定されたネットワークで始めます。
実務なら、まず「読めたか」より「後で照合できるか」を試す
導入効果を確かめやすいのは、紙の請求書だけではありません。複数ページの仕様書を検索用に整える、検査報告書から項目を抽出する、長い取扱説明書の見出しを残して社内検索へ渡す、といった仕事が候補です。ただし、検索やLLMへ渡す前に、元ページへ戻れる情報を残します。読み違いがそのまま回答へ広がるのを防ぐためです。
- 1最初は公開可能な資料か架空教材を使う。公開デモに本番の契約書や顧客情報を送らない。
- 21ページで、日本語、桁数、単位、符号、日付を照合する。今回の教材なら12×150=1,800も人が確認する。
- 3次に2〜3ページで、表の続きを入れる。ページ末尾と次ページ先頭の行が欠けたり、二重になったりしないかを調べる。
- 4実務の試行では、文書ID、ページ番号、生出力、変換後の文章を一緒に保存する。元画像へ戻れる状態を保つ。
- 5同じ資料を既存OCRでも処理し、修正にかかった時間まで比較する。数字の誤りが1件でも残るなら、自動で会計・契約システムへ確定登録しない。
確認項目を残せる評価メモの空欄テンプレートも用意しました。ページをまたぐ表は、このモデルの価値を判断する重要な試験です。今回の簡単な1枚で読めたことを、長い日本語文書の合格判定には使わないでください。
次のOCR出力を、原本を確認する人のための点検表にしてください。出力にない値を補わず、不明は不明としてください。文書ID・ページ番号・原文の抜粋を各項目へ付けてください。金額、数量、単位、日付、否定表現を抜き出し、ページをまたぐ表の欠落・重複の疑いを挙げてください。原本画像が渡されていない場合、読み取りが正しいとは判定せず、照合が必要な箇所だけ列挙してください。単ページの日本語帳票や、値がどこに書かれているかを確認したい場合は、LightOnOCR-3の日本語試用記事も参照してください。今回のUnlimited-OCR-2は、長い文書の構造を保つ設計が新しい一方、導入判断には自分の資料での確認が残ります。
確認した版:モデル9cf077c4、公式GitHub b6c3855e、公開デモfc4316be(いずれも2026年10月28日確認)。デモが実行時に取得した重みの正確なリビジョンはレスポンスから確認できないため、試用結果を特定の重みへ厳密に固定した再現実験とは扱いません。実施したのは日本語画像1枚のデモ推論と、その実出力の公式スクリプトによる後処理です。